Creator Hub
Atrás

Cómo evitar distorsiones en videos con IA: 10 consejos que realmente funcionan

Higgsfield
La distorsión en video con IA no es un problema de calidad. Es un problema de memoria. Cada modelo genera cada frame como una interpretación nueva de tu prompt sin recordar el anterior. Aquí te explicamos por qué ocurre y cómo corregirlo antes de que el modelo se ejecute.

La distorsión en videos de IA no es un problema de calidad. Es un problema de memoria. Cada modelo genera cada fotograma como una interpretación nueva de tu prompt, sin recordar cómo se veía el fotograma anterior. El resultado: rostros que derivan entre tomas, fondos que se deforman a mitad de secuencia y movimientos que se transforman en algo físicamente incorrecto. Esta guía explica por qué sucede, cómo Higgsfield lo aborda a nivel de generación y diez soluciones prácticas que funcionan en cualquier herramienta de video con IA.


Por qué ocurre la distorsión

Los modelos de video con IA no generan una secuencia como un evento continuo. Interpretan un prompt y producen fotogramas que son individualmente plausibles según ese prompt. Cuando el modelo continúa una secuencia o regenera una toma, no está consultando un recuerdo de cómo se veía el primer fotograma. Está interpretando el prompt de nuevo, y las interpretaciones ligeramente distintas producen rostros ligeramente distintos, fondos ligeramente distintos y físicas ligeramente distintas.

Tres tipos de distorsión tienen tres causas diferentes.

La deriva facial ocurre porque las descripciones de texto de una persona son ambiguas. "Una mujer joven con cabello castaño y una mandíbula marcada" puede verse como cientos de personas diferentes. Sin un ancla de identidad, el modelo elige una interpretación nueva cada vez.

La deformación del fondo ocurre porque los elementos del fondo tienen baja prioridad en la mayoría de los prompts. El modelo los completa según el contexto, y ese contexto cambia ligeramente entre fotogramas sin que se lo pidas.

La transformación del movimiento ocurre porque el movimiento físico es difícil de describir en texto. "Correr" puede interpretarse como docenas de posiciones corporales diferentes, y las transiciones entre fotogramas no siempre respetan la física de cómo se mueven realmente los cuerpos.
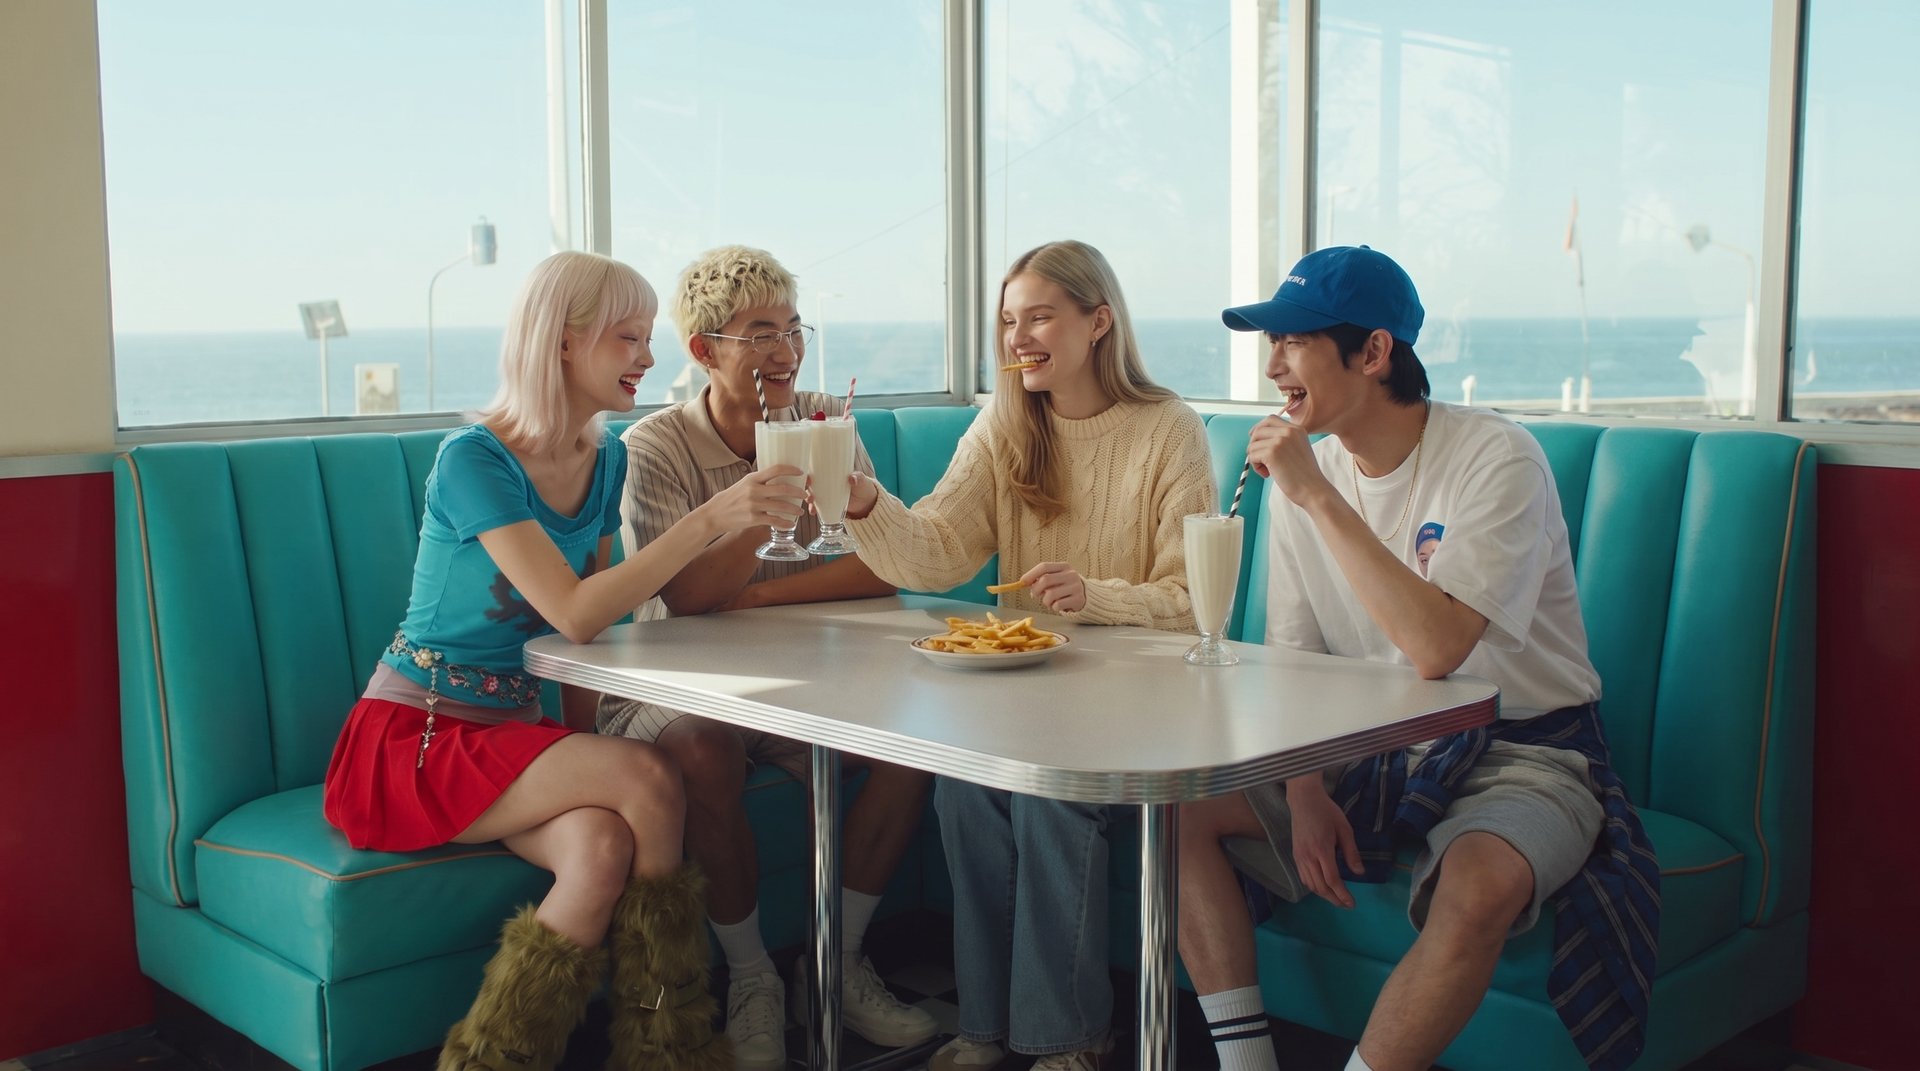
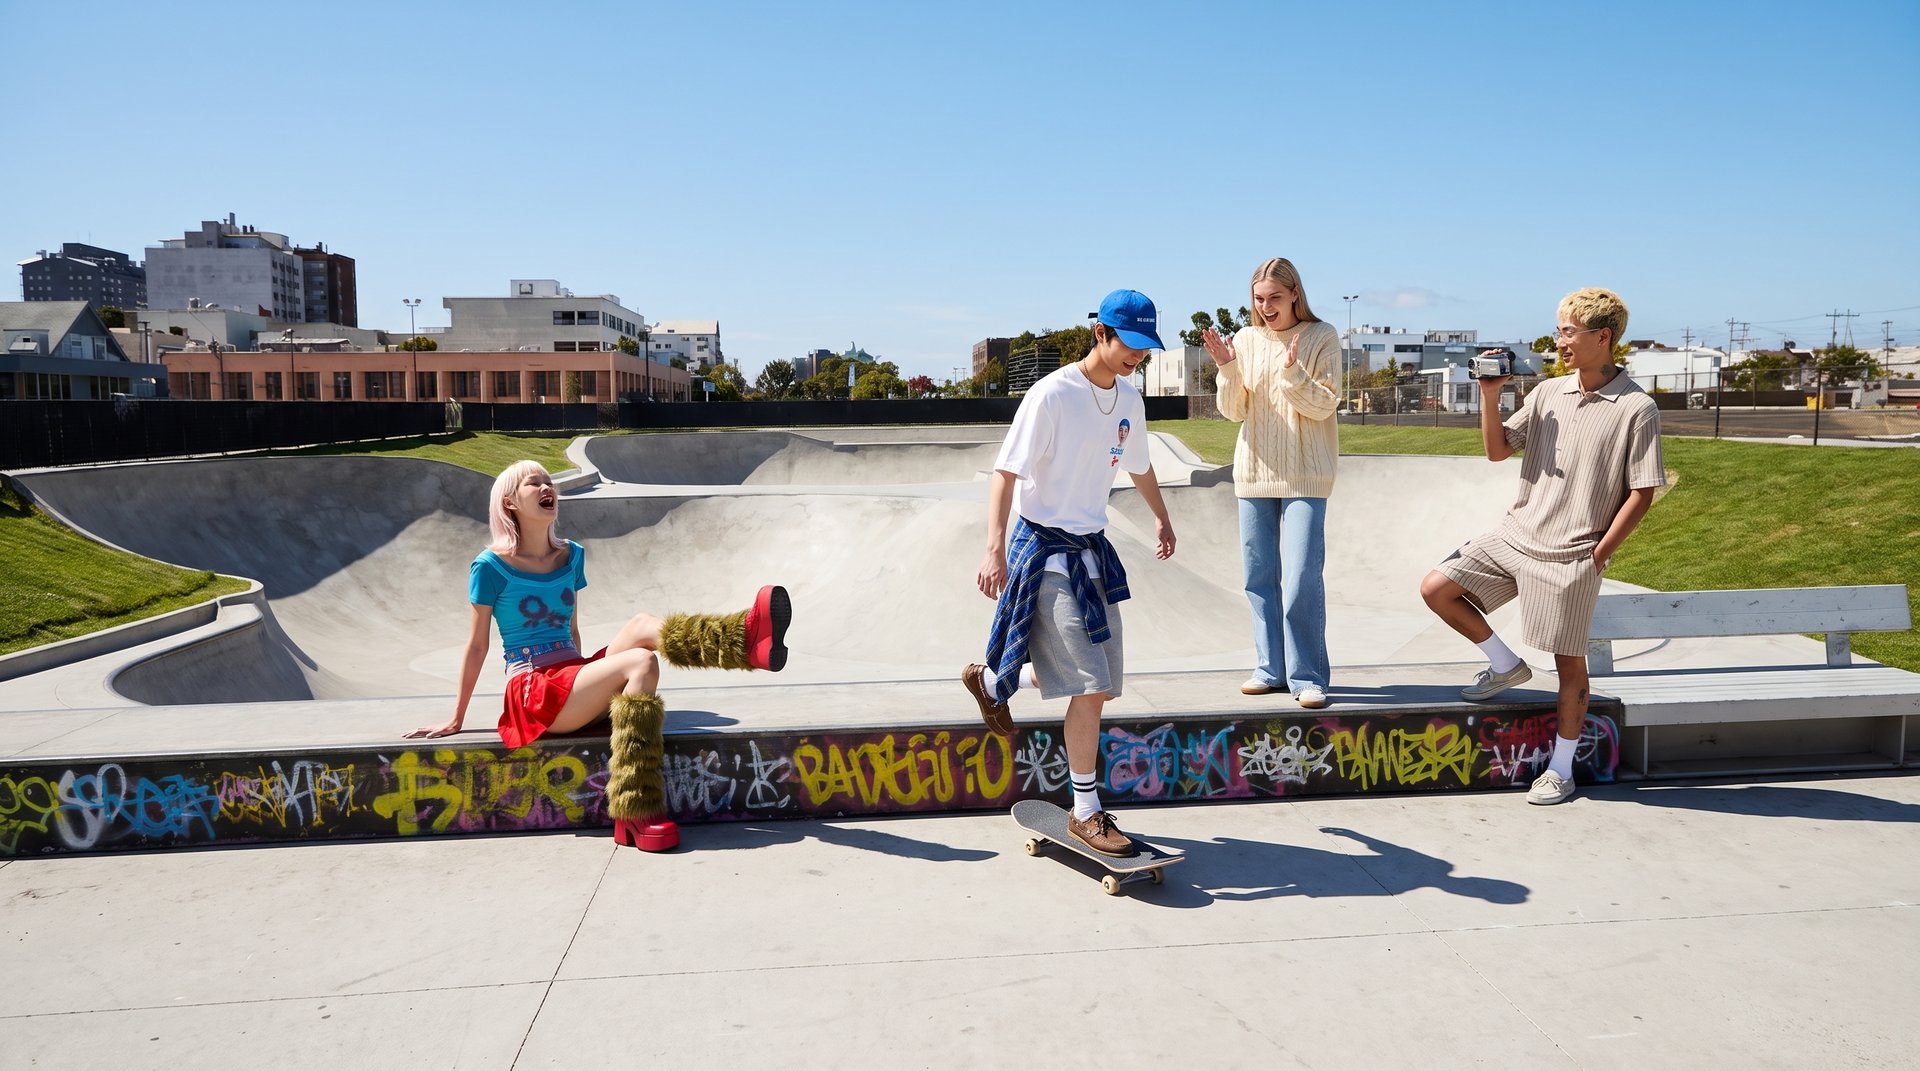
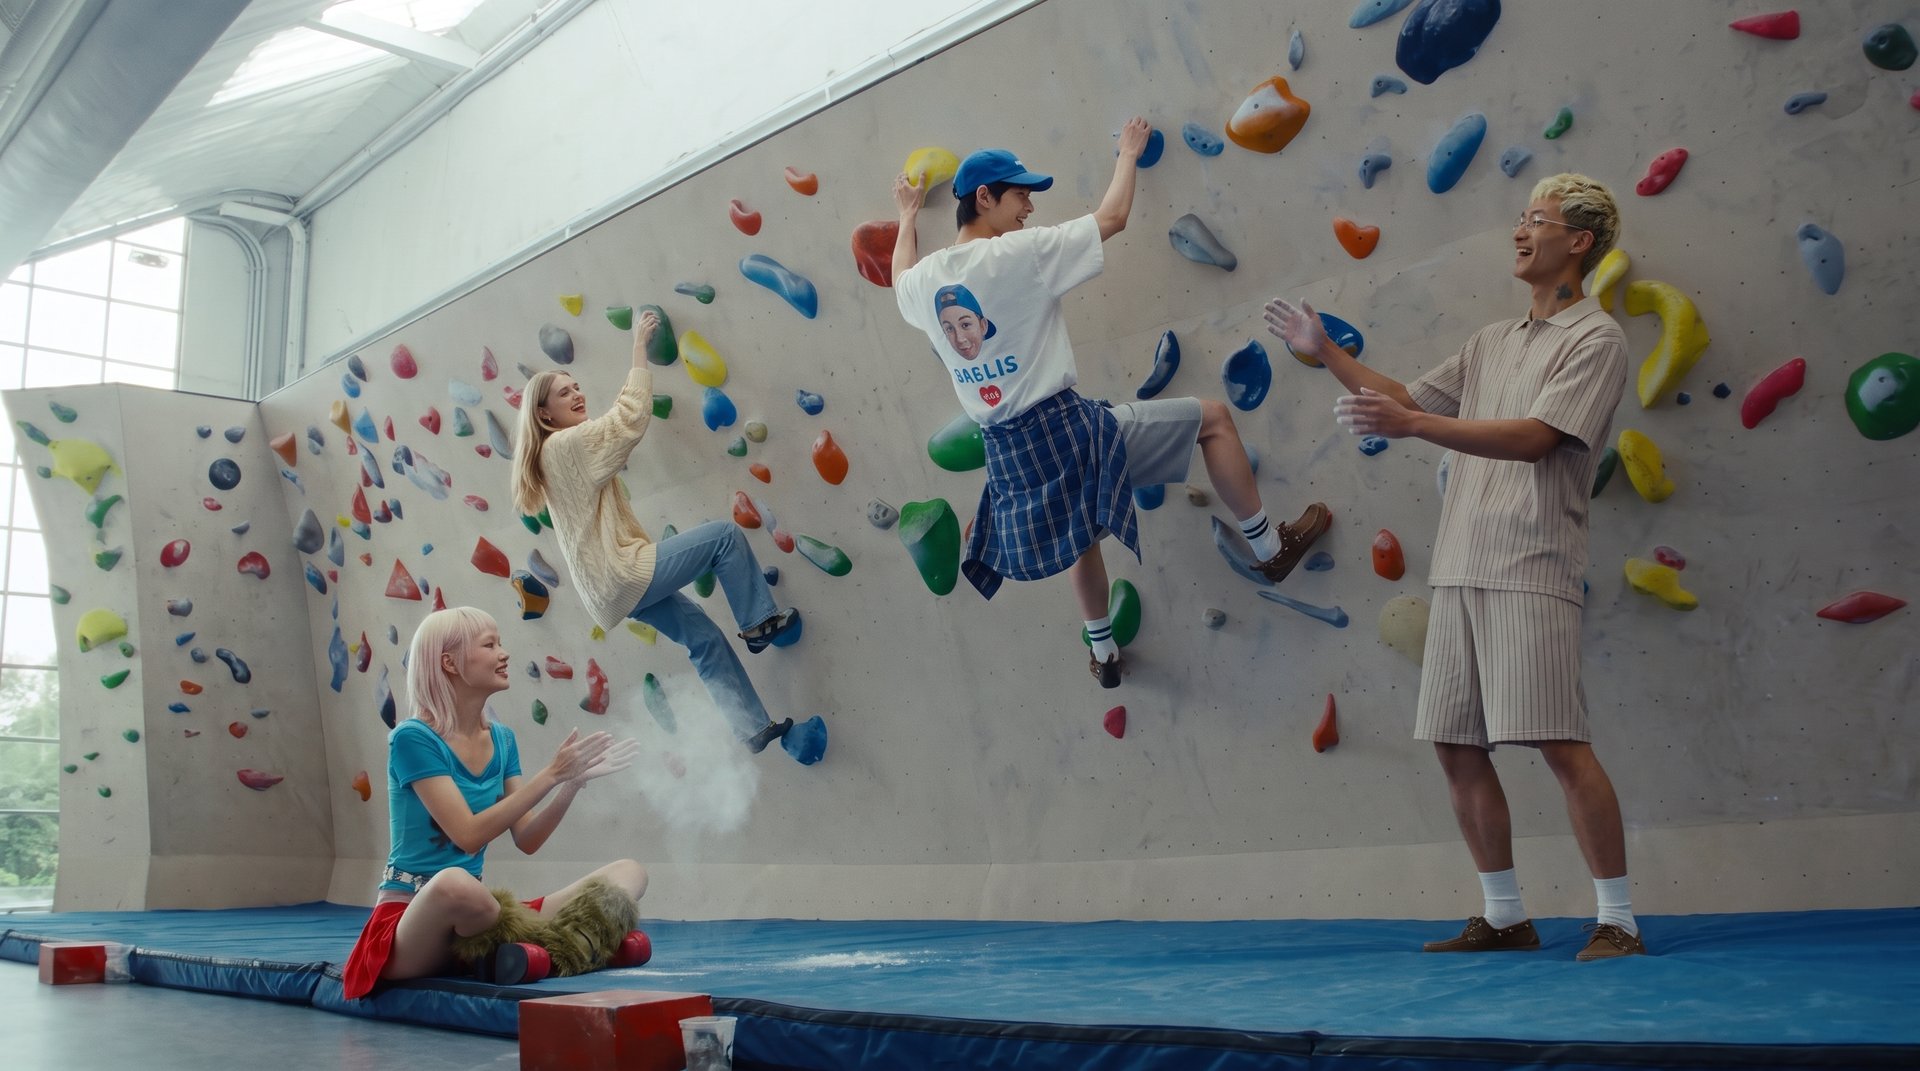
10 consejos para evitar la distorsión

1. Escribe un prompt sólido y específico

Los prompts vagos le dan al modelo margen para interpretar, y cada interpretación es ligeramente diferente. Describe el sujeto, la escena, la acción y la posición de la cámara con la mayor especificidad posible. Cuanto más precisamente defina el prompt el fotograma, menos completa el modelo por inferencia, y la inferencia es donde comienza la deriva.

2. Usa imágenes de referencia de alta calidad

Una foto de referencia borrosa o una sola imagen desde un ángulo le da al modelo menos a qué anclarse. Usa fotos de referencia claras y bien iluminadas desde varios ángulos. Un retrato frontal limpio y una toma de tres cuartos juntos le dan al modelo suficiente información para mantener el rostro consistente sin adivinar.

3. Reemplaza las descripciones de texto con anclas de identidad

Las descripciones de texto de una persona son ambiguas. "Una mujer con cabello castaño y una mandíbula marcada" puede verse como cientos de personas diferentes. Un objeto de identidad entrenado es una restricción rígida que el modelo no puede reinterpretar. Ya sea que uses Soul ID en Higgsfield, un LoRA en otro entorno o una imagen de referencia bloqueada, la identidad debe ser algo que el modelo aplique en lugar de interpretar.

4. Evita movimientos de cámara extremos

Los giros rápidos, los cambios repentinos de dirección y los movimientos de cámara complejos en varias direcciones son difíciles de mantener físicamente coherentes entre fotogramas para el modelo. Usa movimientos suaves en una sola dirección. Si la toma necesita energía, créala mediante el ritmo de edición en lugar del caos de cámara.

5. Configura explícitamente el lente, la iluminación y los parámetros de la cámara

En plataformas con controles explícitos, fija estos como parámetros de producción antes de generar. En Cinema Studio en Higgsfield, los siete presets de iluminación y las seis opciones de lente se aplican al momento de la generación en lugar de inferirse del lenguaje. El mismo preset en cada toma significa la misma configuración física en cada toma. En plataformas sin controles, describe la fuente de luz, la dirección, la calidad y el carácter del lente de forma idéntica en cada prompt.

6. Ancla el fondo con una referencia de locación

La deriva del fondo ocurre porque los fondos están poco especificados en la mayoría de los prompts. Sube una imagen de referencia de la locación junto con la referencia del personaje en cada generación. El modelo ancla el fondo visualmente en lugar de generar una interpretación nueva del texto cada vez. Usa la misma referencia de locación en cada toma de la secuencia.

7. Describe las acciones físicas con posiciones de inicio y fin

"Correr" es ambiguo. "Pie izquierdo adelante, brazo derecho atrás, torso inclinado hacia el movimiento, cabeza nivelada" no lo es. Para movimientos complejos, describe la posición del cuerpo al inicio y la posición del cuerpo al final por separado. Deja que el modelo infiera la transición entre dos puntos específicos en lugar de a partir de una descripción del movimiento.

8. Cambia una variable a la vez entre tomas

Nuevo escenario con el mismo ángulo: el personaje se mantiene, el entorno cambia. Nuevo ángulo con el mismo escenario: el personaje y el registro visual permanecen estables. Cambiar escenario, ángulo e iluminación al mismo tiempo le da al modelo demasiada libertad. Este solo hábito reduce la deriva de identidad más que casi cualquier otro ajuste.

9. Mantén los clips cortos y encadénalos con bloqueos de fotogramas

La deriva se acumula con el tiempo. Incluso en modelos potentes, la deriva de identidad y la repetición de expresiones aparecen después de los 30 segundos. Genera clips más cortos y encadénalos. Usa el último fotograma de cada clip como referencia del primer fotograma del siguiente. Seedance 2.0 acepta entradas de primer y último fotograma específicamente para esto: ancla ambos extremos de un clip y el modelo completa la transición entre dos puntos visuales.

10. Prueba primero la toma más difícil

Las interacciones entre varios personajes y las secuencias de acción dinámicas acumulan más distorsión que las tomas de un solo personaje. Cuando dos personajes comparten un primer plano o interactúan físicamente, aparece el desenfoque de identidad en los puntos de intersección. Prueba primero la toma más compleja. Si se distorsiona de forma consistente, ajusta la especificidad del prompt antes de generar la secuencia completa. Empezar con la toma más fácil y dejar la más difícil para el final significa descubrir el problema cuando la mayor parte del trabajo ya está hecha.


Cómo Higgsfield AI aborda la distorsión

La mayoría de las correcciones de distorsión ocurren en posproducción: rotoscopia manual, in-painting, corrección fotograma a fotograma. Higgsfield aborda la distorsión a nivel de generación mediante dos herramientas que trabajan juntas: Soul ID para el anclaje de identidad y Cinema Studio para el control de movimiento y cámara a nivel de producción.

El flujo de trabajo se ve así:

Fotos de referencia → entrenamiento de Soul ID → identidad entrenada aplicada en cualquier modelo → Cinema Studio para configuraciones de cámara, iluminación y movimiento por toma → video cinematográfico con personaje y física consistentes.

Soul ID entrena una identidad persistente a partir de 20 fotos de referencia de una persona real. Sube las fotos, espera de cinco a diez minutos y, a partir de ese momento, cada generación aplica la estructura ósea, el tono de piel y la geometría facial de esa persona a nivel del modelo. El rostro no se describe en el prompt. Se aplica como un objeto entrenado que el modelo trata como una restricción rígida. Soul ID funciona en toda la pila de modelos de Higgsfield: Kling 3.0, Veo 3.1, Seedance 2.0 y WAN 2.6. La misma identidad está disponible en Cinema Studio, Marketing Studio y LipSync Studio sin volver a subir ni volver a describir el personaje en cada herramienta.

Cinema Studio te da control a nivel de producción sobre las variables que causan la distorsión del movimiento. El movimiento de cámara es una decisión de producción, no una descripción de texto. La iluminación, el carácter del lente y la paleta de colores se aplican al momento de la generación en lugar de aproximarse a partir del lenguaje del prompt. El resultado es un movimiento que se comporta de forma predecible porque el modelo tiene parámetros físicos explícitos con los que trabajar en lugar de inferir todo a partir del texto.


Referencia de configuraciones de Soul ID + Cinema Studio


Referencia de configuraciones de Soul ID + Cinema Studio

Herramienta

Capacidad clave

Qué soluciona

Soul ID

Entrena la identidad a partir de 20 fotos de referencia

Deriva facial entre tomas y sesiones

Soul ID

Funciona en Kling 3.0, Veo 3.1, Seedance 2.0, WAN 2.6

Consistencia del personaje entre modelos

Soul ID

Persiste en Cinema Studio, Marketing Studio, LipSync Studio

Sin volver a subir en cada herramienta

Cinema Studio

Control de cámara por toma (no descrito con texto)

Deriva de cámara y movimiento impredecible

Cinema Studio

7 géneros, 9 paletas de colores, 7 presets de iluminación

Consistencia tonal y atmosférica

Cinema Studio

10 estilos de movimiento de cámara

Lógica de movimiento físicamente precisa

Cinema Studio

6 opciones de lente, 5 distancias focales, 3 ajustes de apertura

Consistencia óptica entre tomas

Corrígelo antes de que el modelo se ejecute

La mayoría de los creadores descubren la distorsión cuando la generación ya está hecha. El rostro se ve diferente en la cuarta toma, el fondo cambió entre cortes, y ahora las opciones son la corrección fotograma a fotograma, una regeneración completa o publicar algo que no es lo que planeaste. Todo esto cuesta más tiempo del que valía el problema.

Los consejos de esta guía son entradas de generación, no herramientas de posproducción. Prompts sólidos, imágenes de referencia de calidad, anclas de identidad entrenadas, parámetros explícitos de cámara e iluminación: estos le dan al modelo restricciones rígidas con las que trabajar en lugar de margen para interpretar. Un modelo que no tiene nada que reinterpretar no tiene nada de qué derivar.

Soul ID y Cinema Studio son esa capa de restricciones en Higgsfield. Una identidad entrenada que el modelo aplica en lugar de adivinar. Movimiento de cámara, iluminación y carácter del lente definidos como decisiones de producción reales en lugar de descripciones en prosa que el modelo puede leer de una docena de maneras distintas. No hace imposible la distorsión. Las escenas con varios personajes y las secuencias dinámicas largas todavía requieren intentos adicionales en todas las plataformas. Pero los problemas más comunes, rostros que derivan, fondos que se deforman, movimientos que se transforman, dejan de ser sorpresas y empiezan a ser algo que planificaste antes de que se generara el primer fotograma.

Cómo evitar distorsiones en videos con IA: 10 consejos que realmente funcionan

Abre Cinema Studio

¿Todavía tienes preguntas?

por Higgsfield