Creator Hub

7 Tools für konsistente KI-Charaktere in jeder Szene 2026

Higgsfield10 min

Sieben Tools lösen KI-Charakter-Konsistenz im Jahr 2026: Soul ID, Flux.2, LoRA, Seedance 2.0, Kling 3.0, Midjourney und Runway Gen-4.5. Jedes löst eine andere Variante desselben Problems: KI-Videomodelle generieren jeden Shot unabhängig, ohne Erinnerung an den vorherigen. Textbeschreibungen reduzieren Drift, beheben ihn aber nicht. Identitätsanker schon.


Welches Tool solltest du wählen?


Welches Tool solltest du wählen?

Dein Ziel

Wahl

Warum

Das Gesicht eines Charakters über alle Shots konsistent halten

Soul ID

Trainiert in 3 – 5 Minuten eine persistente Identität aus 20+ Fotos; funktioniert für echte Personen und KI-generierte Charaktere

Tiefe Identitätsfixierung für Projekte mit 20+ Clips

Flux.2

Basismodell für Charakter-Fine-Tuning; starke Ausgabequalität, um einen Charakter über viele Shots zu fixieren

Kamera- und Bewegungssteuerung pro Shot

LoRA

IC-LoRA-Adapter in ComfyUI fixieren Körperstruktur und Kamera aus Referenzmaterial; erfordert technisches Setup

Werbevideo aus einer Produkt-URL

Seedance 2.0

Sehr starke Prompt-Treue; bis zu 9 Referenz-Inputs; natives Audio; Clips bis zu 15 s

Konsistentes Gesicht in gesprochenen Videos

Kling 3.0

Native Lippensynchronisation in 8+ Sprachen; Multi-Shot mit Charakter-Konsistenz über Schnitte hinweg

Stilisierte oder illustrierte Charaktere über Standbilder hinweg

Midjourney

Style-Reference- und Character-Reference-Parameter fixieren die visuelle Konsistenz über Bilder hinweg

Narratives Multi-Shot-Video ohne Trainingsschritt

Runway Gen-4.5

Einzelnes Referenzbild wird bei der Generierung angewendet; Director Mode für Multi-Shot-Sequenzen

Wann bricht KI-Charakter-Konsistenz tatsächlich zusammen?

Innerhalb einer einzelnen Generierung funktioniert Konsistenz, weil Diffusionsmodelle Video so verarbeiten: Das Modell generiert alle Frames in einem Durchgang und behandelt die gesamte Sequenz als einen einzigen Kontext. Gesicht, Beleuchtung und Geometrie des Charakters bleiben über alle Frames stabil, weil mitten in der Generierung nichts zurückgesetzt wird. Deshalb wirkt ein einzelner Clip, sagen wir 10 Sekunden lang, durchgehend kohärent – selbst bei Kamerabewegung oder wechselnden Winkeln.

Das Problem beginnt, wenn du den nächsten Clip generierst. Jede neue Generierung ist ein frischer Kontext. Keine Erinnerung an die vorherige, keine Übernahme aus dem letzten Prompt. Gleiche Beschreibung, leicht andere Person. Andere Knochenstruktur, ein etwas anderer Hautton, Proportionen, die fast stimmen, aber eben nicht ganz. Bei einem Clip fällt es nicht auf. Über 10 Clips einer Serie ist es offensichtlich.

Ein Identitätsanker bleibt zwischen Generierungen erhalten, statt dass eine Textbeschreibung jedes Mal neu interpretiert wird. Soul ID und Flux.2 kodieren den Charakter einmal und wenden ihn danach auf jede Generierung an. Midjourney und Runway fixieren Konsistenz zum Zeitpunkt der Generierung über ein Referenzbild. Trainierte Modelle halten bei vielen Shots und extremen Winkelwechseln besser. Referenzbasierte Tools sind schneller eingerichtet.
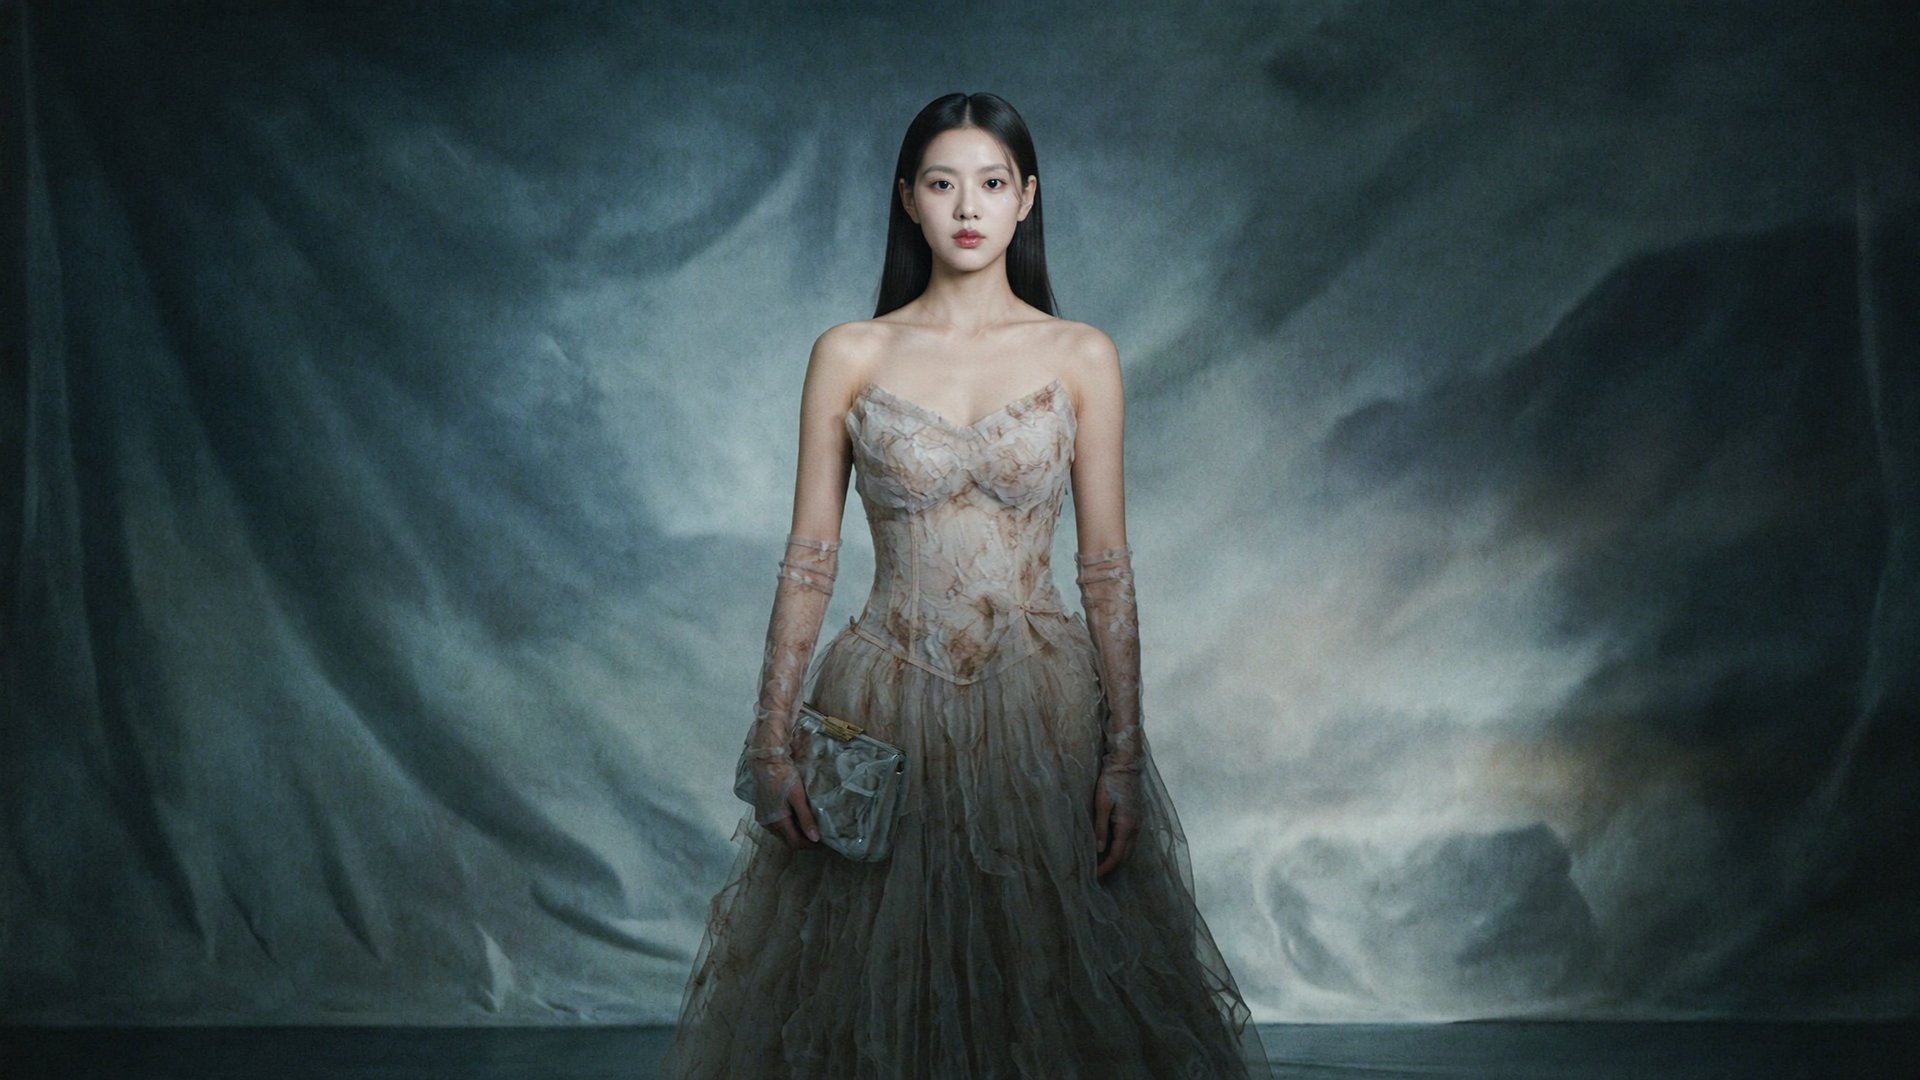
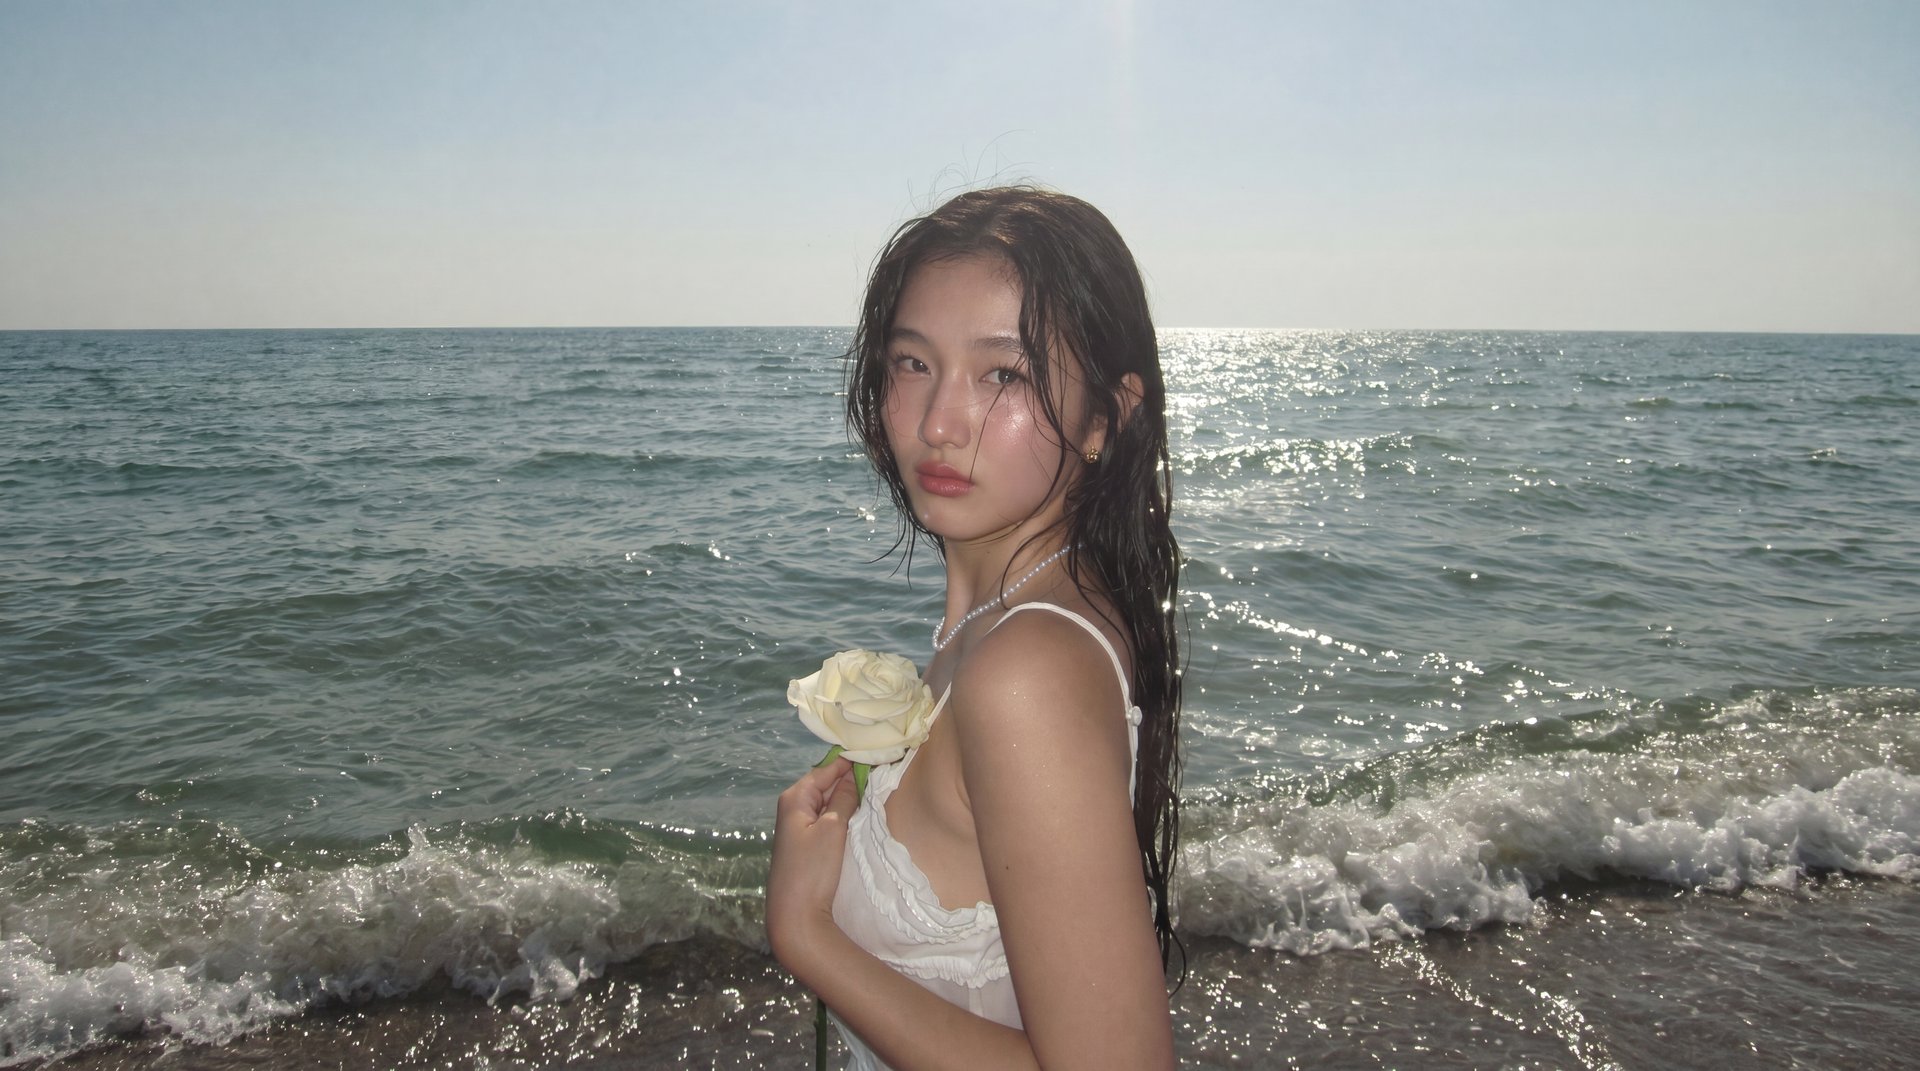
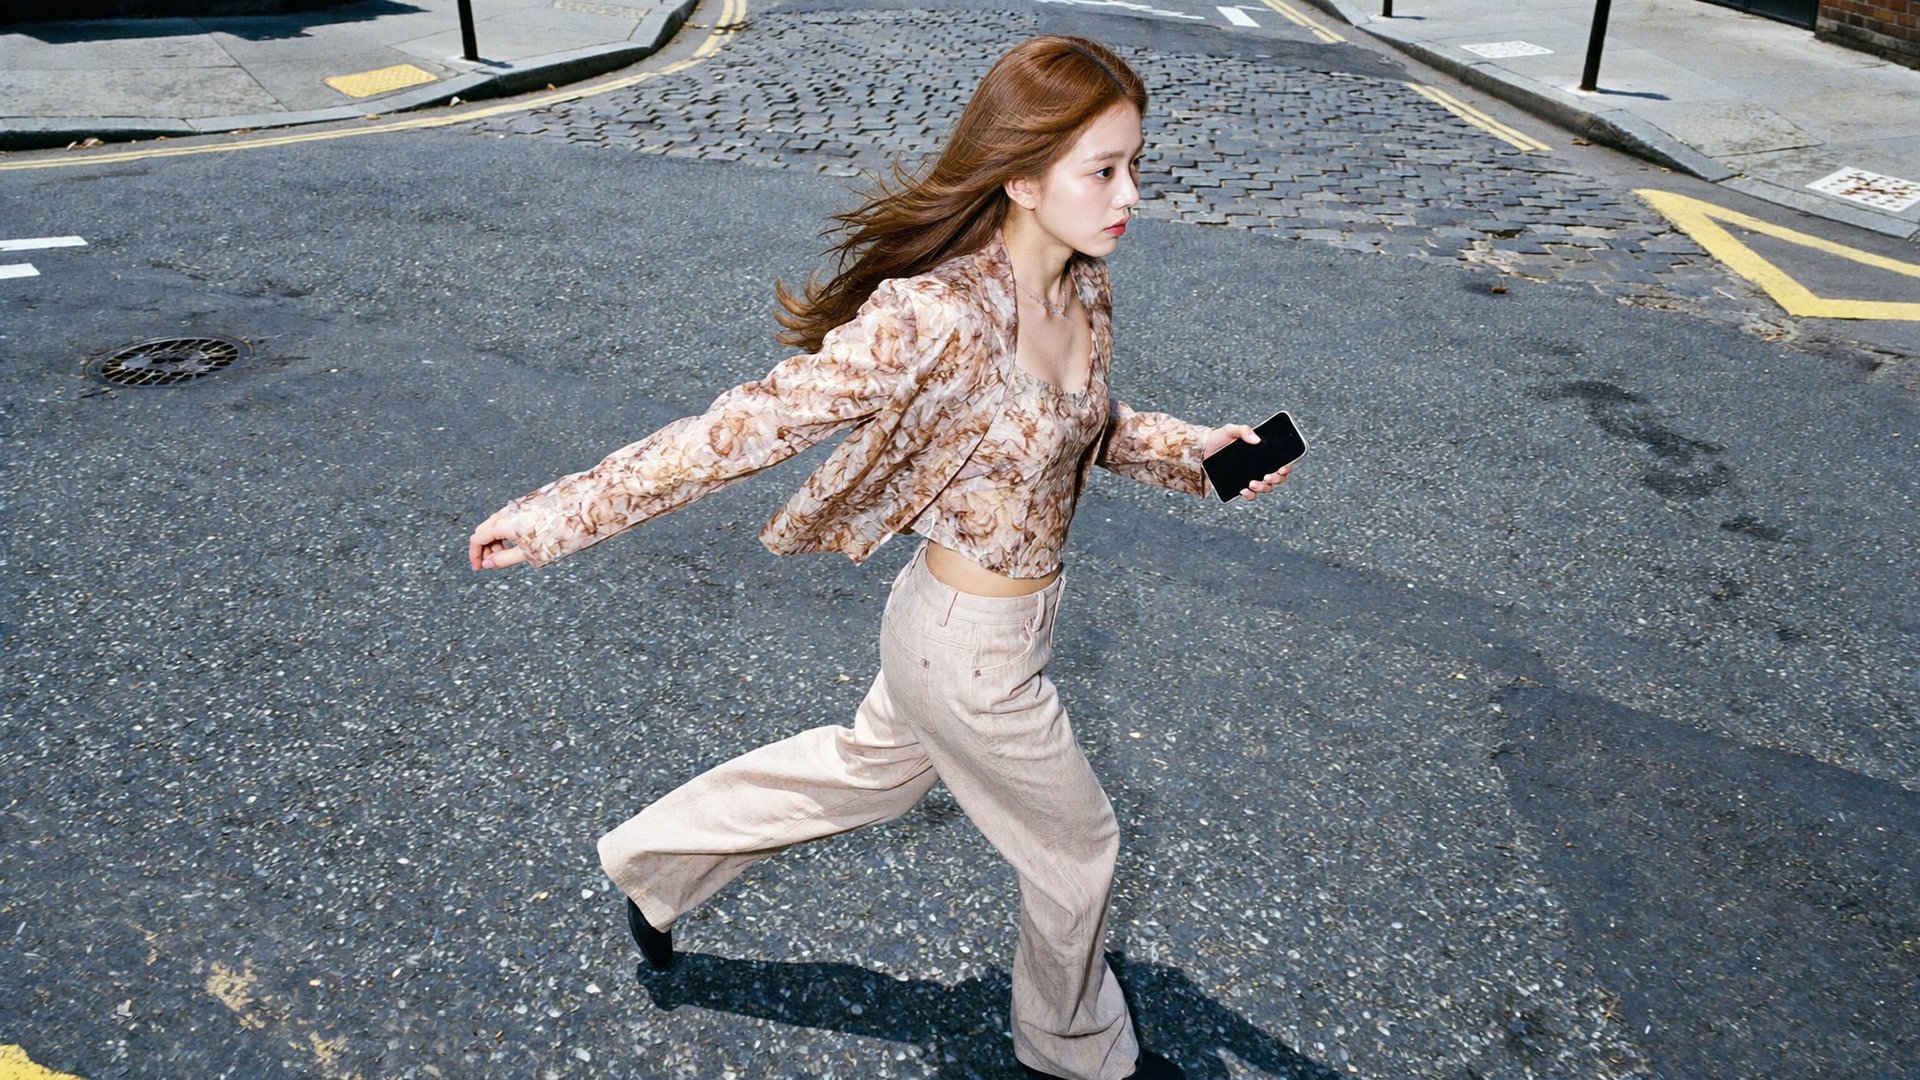
Wie fixierst du das Gesicht einer echten Person über jeden Shot hinweg?

Die meisten Tools nehmen ein Foto und generieren daraus. Das funktioniert für einen Clip. Das Problem: Dasselbe Foto, zweimal in denselben Prompt gegeben, erzeugt zwei leicht unterschiedliche Personen. Soul ID behebt das, indem es aus deinen Referenzfotos ein persistentes Identitätsmodell trainiert, statt jedes Mal ein neues Bild einzulesen.

Stell dir Soul ID wie einen Casting-Datenbankeintrag für eine echte Person vor. Lade 20+ Fotos aus verschiedenen Winkeln hoch, warte 3 – 5 Minuten, und ab diesem Punkt wendet das trainierte Modell Knochenstruktur, Hautton und Gesichtsgeometrie dieser Person auf jede Generierung an. Kein erneutes Hochladen, kein erneutes Beschreiben, kein Hoffen, dass das Modell „braune Haare, markante Kinnlinie“ genauso interpretiert wie beim letzten Mal.

Soul ID funktioniert über den gesamten Modell-Stack hinweg, einschließlich Kling 3.0, Veo 3.1 und Seedance 2.0. Einmal trainiert, ist dieselbe Identität über alle Tools verfügbar – ohne den Charakter jedes Mal neu hochzuladen oder neu zu beschreiben.

Der Character-Reference-Parameter von Midjourney deckt ähnliches Terrain für illustrierte oder stilisierte Gesichter ab, arbeitet aber mit einem einzelnen Referenzbild statt mit einem trainierten Modell. Bei Projekten mit vielen Shots oder extremen Winkelwechseln hält der trainierte Ansatz von Soul ID konsistenter als die Fixierung über ein einzelnes Bild.

Wo Soul ID an Grenzen stößt:

Kein direkter Weg vom Identitätstraining zum Video. Zwei separate Schritte nötig.


Lässt sich ein fiktiver KI-Charakter über Szenen hinweg konsistent halten?

Die meisten KI-Charaktere werden in jedem Prompt von Grund auf neu gebaut. Du beschreibst den Charakter, generierst, bekommst etwas Ähnliches, beschreibst leicht anders – und plötzlich hast du drei Versionen derselben Person, die Cousins sein könnten, aber nicht ganz derselbe Charakter sind. Flux.2 behebt das, indem es den Charakter per Fine-Tuning direkt in die Modellgewichte kodiert. Du definierst den Charakter einmal aus Referenzbildern, und jede Generierung danach wendet dasselbe Gesicht, dieselbe Kleidung und dieselben Proportionen auf Modellebene an, statt zu hoffen, dass der Prompt zweimal gleich landet.

Flux.2 ist das Basismodell, das am häufigsten für Charakter-Fine-Tuning verwendet wird. Sammle 15 – 30 saubere Referenzbilder, starte einen Fine-Tuning-Job, und das resultierende Modell generiert diesen Charakter konsistent – ohne separate Identitätsreferenz zum Zeitpunkt der Generierung. Ein Filmemacher, der eine Serie mit 10 Episoden erstellt, macht das Fine-Tuning einmal. Episode 1 und Episode 10, gedreht in völlig unterschiedlichen Umgebungen mit unterschiedlichen Kamerawinkeln, kommen mit demselben Gesicht zurück, weil die Identität im Modell verankert ist und nicht im Prompt beschrieben wird. Der Preis dafür ist der Setup-Aufwand: Fine-Tuning braucht mehr Zeit und Referenzmaterial als Soul ID, und das resultierende Modell ist auf diesen einen Charakter beschränkt. Für einmalige Projekte ist Soul ID schneller. Für langlaufende Serien mit vielen Shots hält Flux.2 straffer.

Midjourney geht Konsistenz fiktiver Charaktere anders an: über Style-Reference- und Character-Reference-Parameter, die pro Generierung angewendet werden. Das funktioniert gut für konsistente illustrierte Charaktere über statische Bilder hinweg. Der Unterschied zeigt sich bei vielen Shots: Das feinabgestimmte Modell von Flux.2 hält über viele Generierungen und extreme Winkelwechsel straffer, während die Referenzfixierung von Midjourney empfindlicher auf Prompt-Variationen reagiert und sich vor allem für stilisierte Charaktere eignet, bei denen kleine Unterschiede akzeptabel sind.

Wo Flux.2 an Grenzen stößt:

Fine-Tuning erfordert mehr Referenzbilder und Setup-Zeit als Soul ID.

Das resultierende Modell ist charakterspezifisch; für jeden neuen Charakter ist ein neues Fine-Tuning nötig.


Wie fixierst du Körperstruktur und Kamera über Shots hinweg?

Die meisten Identitätstools konzentrieren sich aufs Gesicht. LoRA geht weiter und kodiert Körperstruktur, Kleidung und Kameraverhalten direkt in die Modellgewichte. IC-LoRA-Adapter in ComfyUI erweitern das um Kamerasteuerung: Fixiere Kamerawinkel, Brennweite und Bewegungsmuster eines Referenz-Shots und wende sie konsistent auf eine Sequenz an.

Der praktische Anwendungsfall: Du hast Referenzmaterial mit einer bestimmten Kamerabewegung oder Charakterpose und willst, dass jeder generierte Shot dieser Struktur entspricht. IC-LoRA liest die Referenz ein und kodiert sie als Constraint für die Generierung. Das Ergebnis ist eine straffere Kontrolle pro Shot, als Text-Prompting oder rein gesichtsbasierte Identitätstools erreichen.

Der Preis dafür ist das Setup. ComfyUI erfordert nodebasierte Konfiguration, Modellverwaltung und Vertrautheit mit der Toolchain. Für Teams mit technischer Pipeline fügen LoRA-Adapter eine Kontrollebene hinzu, die höher abstrahierte Tools nicht bieten. Für Solo-Creator oder nicht-technische Workflows sind Soul ID oder Runway Gen-4.5 die praktischeren Einstiegspunkte.

Wo LoRA an Grenzen stößt:

Erfordert ComfyUI-Setup und technische Vertrautheit mit nodebasierten Workflows.


Einen Markenbotschafter über Werbevideos hinweg einsetzen

Die meisten Videomodelle generieren einen gut aussehenden Clip, tun sich aber schwer, dasselbe Gesicht über verschiedene Formate, Winkel und Copy-Varianten zu halten. Seedance 2.0 ist genau dafür gebaut: hochwertige kommerzielle Ausgabe mit starker Prompt-Treue, bis zu 9 Referenz-Inputs, nativem Audio und Clips bis zu 15 Sekunden.

Die Charakter-Konsistenz-Ebene entsteht, indem du Soul ID vor dem Generieren verbindest. Trainiere den Markenbotschafter einmal, verbinde die Identität mit Seedance 2.0, und jede Variante (andere Plattform, andere Zielgruppe, anderer Copy-Ansatz) kommt mit demselben Gesicht zurück – ohne die Referenz jedes Mal neu aufzubauen.

Die Einschränkung ist der Umfang. Seedance 2.0 spielt seine Stärken bei strukturierten kommerziellen Formaten aus. Kreativ-Briefings außerhalb üblicher Ad-Strukturen führen zu schwächeren Ergebnissen.

Wo Seedance 2.0 an Grenzen stößt:

Die Ausgabequalität hängt vom Briefing ab; spärliche Inputs führen zu schwächeren Ergebnissen.

Weniger flexibel für narrative oder cineastische Formate außerhalb kommerzieller Strukturen.


Kannst du dasselbe Gesicht über gesprochene Videoclips hinweg behalten?

Kling 3.0 beherrscht gesprochene Videos mit nativer Lippensynchronisation in 8+ Sprachen. Wo die meisten Videomodelle Audio-Sync als Nachbearbeitungsschritt behandeln, generiert Kling 3.0 Mimik und Lippenbewegung zusammen in einem Durchgang – so bleibt der emotionale Ausdruck des Gesichts an der Stimme ausgerichtet, statt im Nachhinein angenähert zu werden.

Die meisten Lip-Sync-Tools behandeln jeden Clip als eigenständigen Job. Du lädst ein Foto hoch, fügst Audio hinzu, bekommst einen Clip und lädst dasselbe Foto für den nächsten wieder hoch. Das Gesicht driftet zwischen den Clips, weil das Modell das Bild jedes Mal neu einliest. Mit Kling 3.0 hält dasselbe Gesicht durch eine Multi-Clip-Sequenz, ohne dass du pro Clip eine Referenz neu hochlädst.

Verbinde Soul ID vor dem Generieren, und die trainierte Identität fließt automatisch in jeden gesprochenen Clip ein. Das Gesicht, das in Clip 1 spricht, ist dasselbe Gesicht in Clip 10 – gleiche Knochenstruktur, gleicher Hautton, ohne den Charakter zwischen Generierungen neu zu beschreiben.

Wo Kling 3.0 an Grenzen stößt:

Die Ausgabequalität variiert bei komplexer Gesichtsgeometrie.

Längere Skripte müssen in kürzere Clips aufgeteilt werden.


Illustrierte oder stilisierte Charaktere über Bilder hinweg konsistent halten

Midjourney geht Charakter-Konsistenz über Referenzparameter an statt über trainierte Identitätsmodelle. Der Character-Reference-Parameter fixiert das visuelle Erscheinungsbild eines Charakters über neue Generierungen hinweg. Der Style-Reference-Parameter verankert die Gesamtästhetik. Zusammen eingesetzt, reduzieren sie Charakter-Drift bei illustrierten und stilisierten Personas deutlich – ohne separaten Trainingsschritt.

Der Workflow: Generiere zuerst ein starkes Charakter-Referenzbild und übergib es dann als Character Reference in nachfolgenden Prompts. Midjourney interpretiert die Referenz und wendet die zentralen visuellen Merkmale des Charakters auf die neue Generierung an. Für illustrierte Marken-Maskottchen, fiktive Charaktere in konsistenten Stilen und jeden Charakter, der kein fotorealistisches echtes Gesicht ist, ist das ein besonders praktischer Ausgangspunkt.

Verglichen mit Flux.2 oder Soul ID reagiert die Referenzfixierung von Midjourney empfindlicher auf Prompt-Variationen. Ein deutlich anderer Prompt kann die Referenz überschreiben. Eignet sich vor allem für stilisierte Charaktere, bei denen kleine Abweichungen akzeptabel sind, nicht für fotorealistische Gesichter, bei denen exakte Geometrie zählt.

Wo Midjourney an Grenzen stößt:

Nur Bildausgabe; keine native Video-Generierung.

Character-Reference-Fixierung ist bei vielen Shots oder extremen Winkeln schwächer als ein trainiertes Identitätsmodell.


Wie fixierst du Charakter-Identität direkt im Video?

Runway Gen-4.5 wendet ein einzelnes Referenzbild als Identitätsanker zum Zeitpunkt der Video-Generierung an. Kein Trainingsschritt, keine Asset-Verwaltung über das Bereithalten des Referenzbilds hinaus. Lade ein Porträt hoch, und das Modell wendet diese Identität über verschiedene Umgebungen, Kamerawinkel und Shot-Kompositionen hinweg an.

Director Mode erweitert das auf Multi-Shot-Sequenzen: Beschreibe ein Skript, setze die Character Reference, und Runway generiert eine Sequenz mit konsistenter Charakter-Identität über Schnitte hinweg. Für eine narrative Sequenz mit 3 – 5 Shots ohne Setup-Zeit ist das einer der direktesten Wege vom Referenzbild zum fertigen Video.

Verglichen mit Soul ID ist der Aufwand pro Shot geringer, weil es keinen Trainingsschritt gibt. Der Kompromiss: Ein einzelnes Referenzbild gibt dem Modell weniger Material als ein trainiertes Modell – das zeigt sich bei Shots mit extremen Winkelwechseln oder ungewöhnlicher Beleuchtung. Für Projekte mit knappem Zeitrahmen, bei denen Trainingszeit ein Hindernis ist, ist der Ansatz von Runway praktisch. Für längere Kampagnen oder Serien mit vielen Shots hält die trainierte Identität von Soul ID in der Regel konsistenter.

Wo Runway Gen-4.5 an Grenzen stößt:

Die native Cliplänge beträgt 16 Sekunden; längere Sequenzen erfordern Extend, was die Konsistenz beeinträchtigen kann.

Kein natives Audio; jedes Projekt braucht einen separaten Audio-Workflow.


Wie erstellst du eine Geschichte über mehrere Szenen mit konsistenten Charakteren?

Starte mit dem richtigen Identitätstool. Echte Person: Soul ID. Tiefe Identitätsfixierung für lange Projekte: Flux.2. Illustrierter oder stilisierter Charakter in Standbildern: Midjourney mit Character Reference. Schnelle Multi-Shot-Videonarrative: Runway Gen-4.5. Kommerzielles Markenbotschafter-Video: Soul ID mit Seedance 2.0. Gesprochenes Video mit Lippensynchronisation: Kling 3.0.

Generiere zuerst die Ankerszene. Beginne mit dem wichtigsten Shot, meist einer sauberen Nahaufnahme. Nimm die zentralen visuellen Merkmale des Charakters in jeden folgenden Prompt auf: Haare, Kleidung, markante Details. Modelle haben zwischen Generierungen kein Gedächtnis. Die Wiederholung ist Absicht.

Ändere eine Variable nach der anderen. Neues Setting, gleicher Winkel. Neuer Winkel, gleiches Licht. Mehrere Variablen gleichzeitig zu ändern ist die häufigste Ursache für Identitäts-Drift – bei allen Tools hier.


Wo liegen die Grenzen der KI-Charakter-Konsistenz 2026?

Interaktion mehrerer Charaktere ist auf allen Plattformen ungelöst. Zwei Charaktere halten ihre individuellen Identitäten isoliert, aber sobald sie sich eine Nahaufnahme teilen oder physisch interagieren, verschwimmen die Identitäten an den Berührungspunkten. Das gilt für Soul ID, Runway, Midjourney und jedes andere Tool in dieser Liste.

Langform-Konsistenz lässt bei den meisten Modellen ab 30 Sekunden nach. Wiederholte Gesichtsausdrücke und subtiler Drift treten selbst bei stärkeren Ausgaben auf. Plane bei allem, was länger ist, zusätzliche Regenerierungsversuche ein.

Dynamische Actionsequenzen (Kampf, Sport, schnelle Umgebungsbewegung) erfordern bei jedem hier gelisteten Tool mehrere Regenerierungsversuche. Das ist eine Einschränkung auf Modellebene, keine Workflow-Frage.


Mit welchem Tool solltest du starten und was kostet es?

Echte Person, jedes Format: Soul ID auf Higgsfield

Tiefe Identitätsfixierung, Projekte mit 20+ Clips: Flux.2

Illustrierter oder stilisierter Charakter, nur Standbilder: Midjourney mit Character Reference

Schnelle Multi-Shot-Videonarrative ohne Training: Runway Gen-4.5 mit Director Mode

Kommerzielles Markenbotschafter-Video: Seedance 2.0 mit Soul ID

Gesprochenes Video mit Lippensynchronisation: Kling 3.0

Higgsfield (Soul ID, Flux.2, Seedance 2.0, Kling 3.0) läuft unter einem Abo. Starter 15 $ pro Monat (200 Credits); Plus 49 $ pro Monat (1.000 Credits) schaltet das komplette Modell-Lineup inklusive Veo 3.1 frei. Veo 3.1 kostet 58 Credits pro 1080p-Clip.

LoRA läuft lokal über ComfyUI ohne Softwarekosten. Die Rechenkosten hängen von deiner Hardware oder deinem Cloud-Anbieter ab.

Midjourney: Basic 13 $ pro Monat, Standard 30 $ pro Monat, Ultimate 55 $ pro Monat.

Runway Gen-4.5: Standard 12 $ pro Monat, Pro 28 $ pro Monat (jährliche Abrechnung, 2.250 Credits/Monat für ca. 90 Sekunden Gen-4.5).

Prüfe die aktuellen Preise auf jeder Plattform, bevor du dich festlegst.

7 Tools für konsistente KI-Charaktere in jeder Szene 2026

Soul ID testen

Noch offene Fragen?

von Higgsfield